Blender 5.2.1 のテクスチャキャッシュは、初期設定のままではVRAMを減らしませんでした。Texture Cache は最初から有効ですが、Auto Generate(tx ファイルの自動生成)が無効で、tx の無い画像は 3.6 と同じく丸ごと読み込まれます。
Auto Generate を有効にして tx を作ると、8K テクスチャ64枚(従来 16,384MiB)の画像メモリが 720p で 12〜15MiB、4K でも 72MiB 以下になり、描画は約28秒から約0.7秒(720p)に縮みました。代わりに、初回の tx 生成に約61秒かかり、ディスクを使い、1px の細い線は薄くなります。
Blender 5.2 LTS(2026年7月14日公開)の Cycles に入った「テクスチャキャッシュ」は、画像のうち描画に要る部分と解像度だけを読み込む仕組みです。VRAM 16GB で 8K テクスチャを大量に使っても収まるのか。同じ検証機の 3.6.11 と 5.2.1 LTS で同じシーンを描いて比べました。
テクスチャキャッシュとは?何が変わる?
公式のリリースノートによると、画像ごとに「tx ファイル」を作り、描画に要る小さな区画と解像度だけを読み込みます。tx は区画に分けた画像に、半分、4分の1…と縮めた版(ミップマップ)を重ねたファイルで、既定では画像の隣の blender_tx/ にできます。設定はレンダープロパティの Performance > Texture Cache で、公式は Texture Cache と Auto Generate の両方を有効にするよう案内しています。3.6 にはこの機能がありません。
初期設定のままでVRAMは減る?
減りませんでした。5.2.1 の初期設定は Texture Cache が有効、Auto Generate が無効で、3.6.11 で保存した .blend を開いても同じです。この状態で tx の無い画像を描くと、Cycles の統計は「Full Images」(丸ごと読み込んだ)と表示し、画像メモリは 3.6 と同じでした。
| 8K テクスチャ | 3.6.11 | 5.2.1 キャッシュ無効 | 5.2.1 初期設定(tx なし) |
|---|---|---|---|
| 16枚 | 4,096MiB・3.7秒 | 4,096MiB・3.4秒 | 4,096MiB・3.4秒 |
| 64枚 | 16,384MiB・27.5秒 | 16,384MiB・31.5秒 | 16,384MiB・31.3秒 |
値は Cycles が描画後に出す画像メモリと描画全体の時間(8K・8bit は1枚 256MiB)。64枚は VRAM(16,376MiB)を超えますが、どちらの版も描き切りました。5.2.1 の詳細ログでは、初期設定でもキャッシュ無効でも公式マニュアルのとおり12枚(3,072MiB)がメインメモリに置かれ、GPU 全体の増加(nvidia-smi)も約14,500〜14,800MiB で同じでした。
測り方:RTX 4070 Ti SUPER(ドライバ 591.86)、メインメモリ 31.9GiB、Core i7-11700F。8192×8192 の PNG(グラデーションに細い格子線と番号を入れた合成画像)を1枚ずつ貼った板を並べ、1280×720・32サンプル・OptiX・デノイズなしで描画(各条件2回の平均)。2026年9月26日測定。
tx を作るとVRAMはどこまで減る?
Auto Generate を有効にして1回描くと tx が64個でき、以降は切っても tx が使われました(64枚・720p)。
| 64枚・720p | キャッシュ無効 | tx あり |
|---|---|---|
| 画像メモリ(全体が小さく写る) | 16,384MiB | 12.3MiB |
| 画像メモリ(1枚が画面いっぱい) | 16,384MiB | 14.6MiB |
| 描画全体 | 約28秒 | 約0.7秒 |
tx ありの画像メモリは統計の Peak total image memory(描画中の最大)です。GPU 全体の増加(nvidia-smi)も、読み取りが追いつく長い描画(1080p・512サンプル)で測ると、キャッシュ無効の 14,719MiB に対して tx ありは約1,590MiB で、テクスチャを貼らない同じ板(約1,540〜1,590MiB)と同じ水準でした。サンプリングも 7.9秒→3.3秒と速くなりました(キャッシュ無効は1回)。
なぜ 8K が 15MiB に収まるのか
統計には、画像ごとに読んだ段(解像度)と区画の数が出ます。板が小さく写る引きでは、どの画像も 128px と 64px の段だけを読み、8192px の段は1区画も読んでいません。画面の高さいっぱい(約705px)の寄りでは 1024px の段が中心でした。読む量は主に画面に写る大きさで決まり、8K の元の解像度の段は読まれませんでした。
代わりに払うものは?
| 項目 | 結果 |
|---|---|
| 初回の tx 生成 | 8K×64枚で約61秒(1回だけ) |
| ディスク | 合成画像の PNG 計56MiB → tx 計307MiB/乱数で埋めた 8K 1枚は PNG 192MiB → tx 289MiB |
| サンプリングの速さ | 約3%遅い(VRAM に収まる16枚・1080p・512サンプル) |
| 画 | 1px の細い線が薄くなる |
ディスクの増え方は画像の中身で変わります(合成画像は約5.4倍、情報量の多い写真の目安にした乱数の画像は約1.5倍・生成は1枚約3.5秒)。
描画全体は読み込みが無いぶん速くなります(1080p・512サンプル・寄りで 6.7秒→3.9秒)。ただしサンプリングは寄りで 3.29秒→3.39秒、引きで 1.46秒→1.51秒と約3%遅く、リリースノートも「わずかな性能の低下」としています。
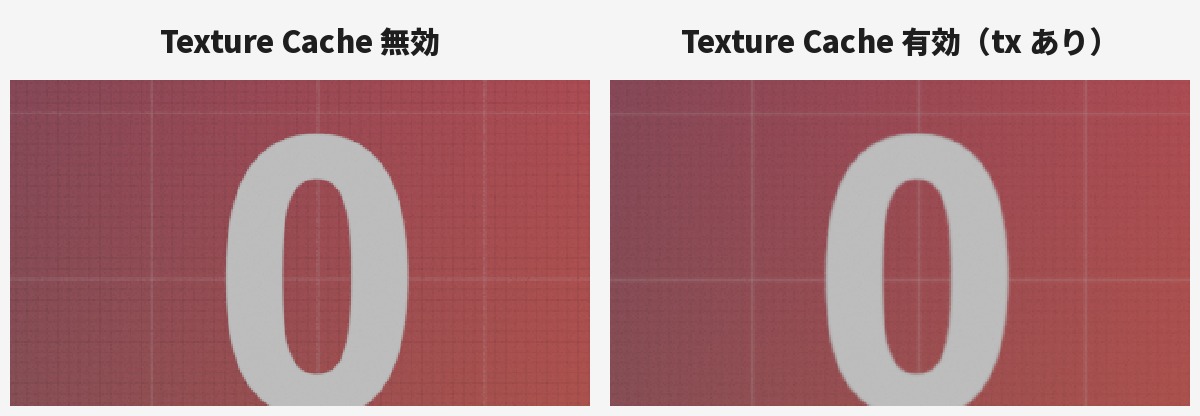
画の差は PSNR 約43dB で、同じ設定を2回描いたときの約90〜103dB より大きい値です(大きいほど近い)。1px の格子線はキャッシュありでほぼ消えました。縮めた段を使うため、画面の1画素より細い模様は平均されて薄くなります。細かい模様を見せる寄りのカットは、キャッシュ無効と見比べてから決めます。
3.6 と 5.2 は同じ設定でも画が変わる(PSNR 約28dB・見た目が変わる理由)ため、画の比較は 5.2 の中で行いました。
4Kで描くとどうなる?
3840×2160 では画面を描画タイルに分けて描くため、使わなくなった区画を捨てる「追い出し」が働きました。統計の Evicted は、寄り・タイル 2048 で読んだ 1,352 区画のうち 1,270 です。
| 64枚・4K・tx あり(ピーク) | タイル 2048(既定) | タイル 1024 |
|---|---|---|
| 1枚が画面いっぱい | 29.3MiB | 15.7MiB |
| 全体が小さく写る | 72.2MiB | 25.9MiB |
キャッシュ無効はどちらも 16,384MiB・約30秒、tx ありは約2.4〜2.7秒でした。公式ブログも、タイルを 1024 や 512 に下げるとさらに減る(速度と引き換え)としています。
どんなときに有効にすべき?
- 画像テクスチャが多く、VRAM や読み込み時間が厳しいシーン:Auto Generate を有効にします(パネルの Generate で先に作ることもできます)。
- 画像をパックした .blend:効きませんでした。tx があっても、パックした4枚は丸ごと(1,024MiB)読み込まれました。先に外部ファイルへ戻します(公式ブログも今後の課題としています)。
- テクスチャが少なく VRAM に余裕があるシーン:読み込みは縮む一方、サンプリングがわずかに遅くなり、ディスクも使います。
コマンドラインなら公式の blender scene.blend --command maketx で作れます。
まとめ
5.2 に上げて 3.6 のファイルを開いただけでは、テクスチャの VRAM は減りません。Auto Generate で tx を作ると、8K×64枚でも画像メモリは数十MiB に収まりました。細かい模様が薄くなる点、パックした画像に効かない点は先に確かめておきます。ジオメトリの重いシーン、実写のテクスチャ、CPU での描画は測っていません。
テクスチャ以外で VRAM が足りないときの GPU 選びは3DCG 向けの RTX 5070 Ti 搭載 BTO、描画の高速化はレンダリング高速化の設定、3.6 から移るかは3.6・4.2 が旧 LTS に入った話、基本はBlender の完全入門へ。


コメント