LoRA作りで最初に決めるのはベースモデルだ。必要なVRAM・学習ツール・使ってよい範囲(ライセンス)がそこで決まる。SDXLとFLUX.1はKohyaのsd-scripts、FLUX.2はAI-Toolkitが対応している(2026年10月5日に各公式で確認)。設定は学習ツールの公式の例から始め、エポックごとに保存して見比べるのが近道だ。
「自分のキャラクターをAIで描かせたい」。その悩みを解決するのがLoRAだ。本記事はsd-scripts・AI-Toolkit・Prodigy・DoRAの論文・各モデルのライセンスなどの一次情報(2026年10月5日に確認)をもとに、データセット・VRAM・パラメータ・ベースモデルの選び方をまとめる。当サイトはLoRAの学習を実測していないので、数値は公式の記載か、一般的な目安として書く。
LoRAとは?2026年の最新トレンド
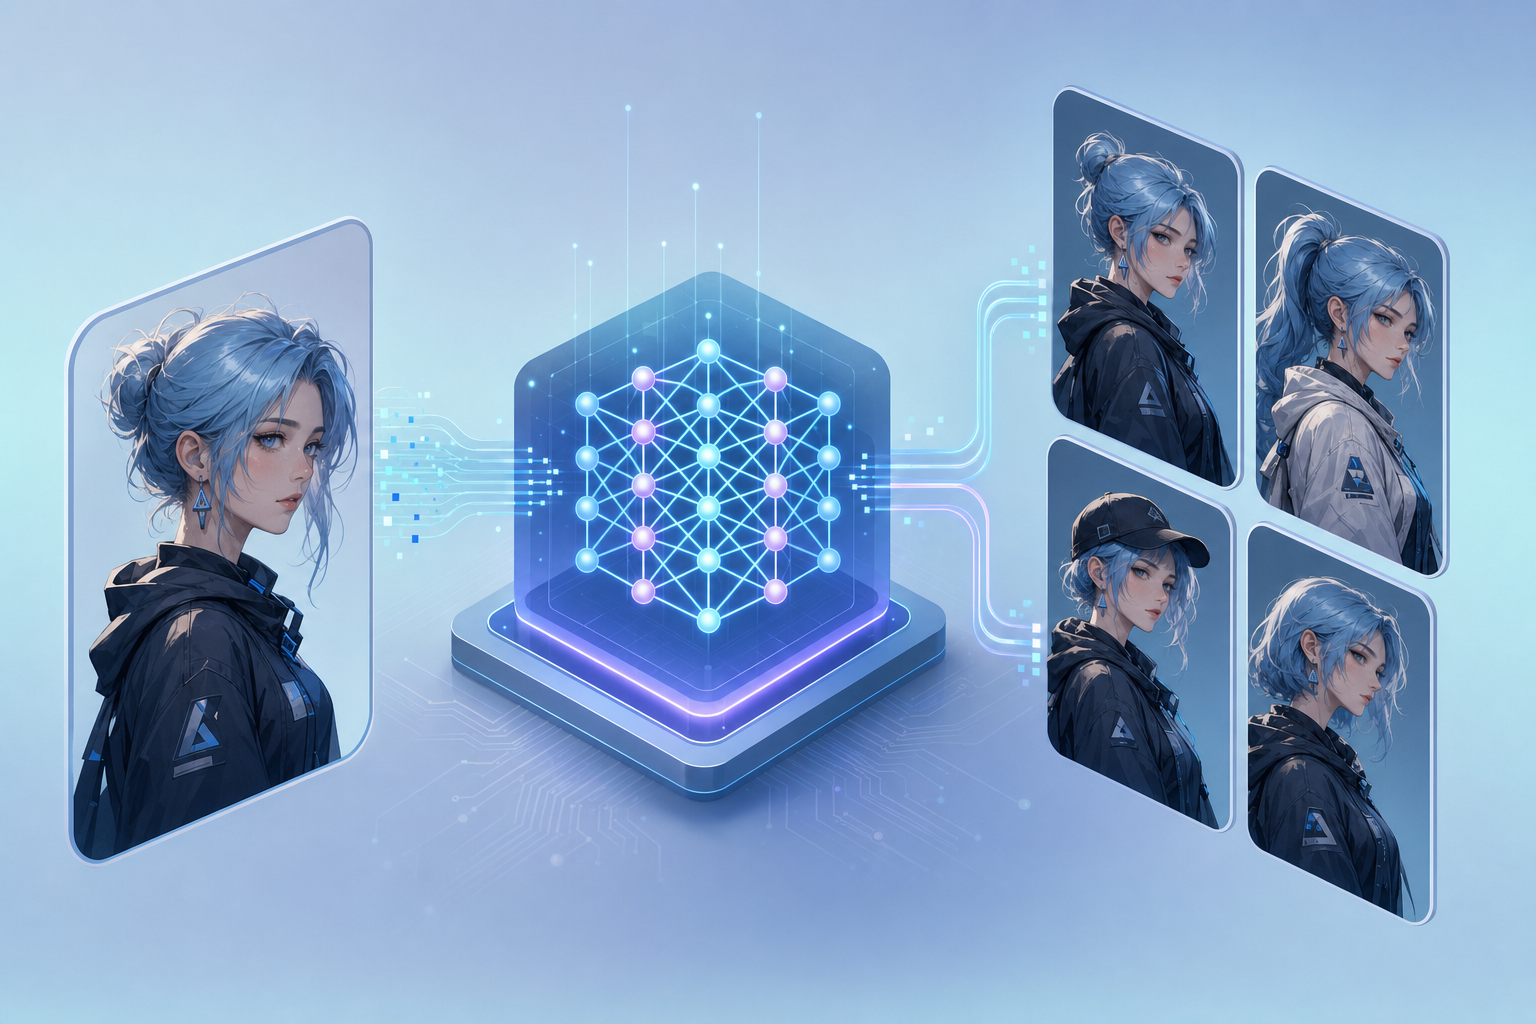
LoRA(Low-Rank Adaptation)は、ベースモデル本体を書き換えずに小さな追加の重みだけを学習して、特定のキャラクターや画風を描けるようにする技術だ。ベースモデルはSD1.5 → SDXL → FLUXへと移ってきた。Kohyaの学習スクリプトsd-scriptsの最新版(0.12.0・2026年9月24日)がLoRAの学習に対応するのはSD1.x/2.x・SDXL・SD3/3.5・FLUX.1・LUMINA・HunyuanImage-2.1・Animaで、FLUX.2は含まれない。ベースモデルが変わると、学習ツールも設定も変わる。
データセット構築の極意——枚数より偏りと画質
画像の枚数と解像度
キャラクターLoRAは数十枚(20〜40枚程度)から始める例が多い。ただしsd-scriptsの文書に推奨の枚数は無く、当サイトも枚数ごとの仕上がりは測っていない。枚数を増やす前に、表情・角度・服装・背景が偏っていないか、圧縮ノイズや極端な照明の画像が混じっていないかを見るほうが先だ。解像度は、SDXLでは高解像度のデータとアスペクト比のバケット(enable_bucket = true)を使うのが一般的だと公式の文書にある。
着せ替えを可能にするキャプション設計
キャプション(画像ごとの説明文)に書いた語は、学習のときにその語と結び付けて覚えられる。逆に、どの画像にも写っているのにキャプションに書かなかった要素は、トリガーワード(キャラクター名の語)の側に吸収されやすい。後から服を着せ替えたいなら、服の語(例:「white dress」)をキャプションに書いておく、という考え方が使われる。公式の文書に決まりがあるわけではないので、迷ったら服の語を書いた版と書かない版を少数の画像で作り、生成して比べるのが確実だ。キャプションを並べ替えて学習するときは、先頭のトリガーワードを固定するkeep_tokensの指定がsd-scriptsにある。
正則化画像は必要か?
単一キャラクターのLoRAでは、正則化画像を使わずに学習する例も多い。使うべきケースと逆効果になる条件はLoRA学習に正則化画像は必要か?にまとめている。
VRAM容量別の最適化設定(2026年版)
必要なVRAMは、ベースモデルと設定で大きく変わる。ここではsd-scriptsの公式の文書に書かれている目安と、VRAMを減らす設定をまとめる(当サイトは学習を実測していない)。
FLUX.1は、公式の文書にVRAM別の設定の表がある(--fp8_baseを使う前提)。
| VRAM | 公式の文書の設定(FLUX.1・sd-scripts) |
|---|---|
| 24GB | 基本の設定で動く(バッチサイズ2) |
| 16GB | バッチサイズ1+--blocks_to_swap |
| 12GB | --blocks_to_swap 16+8bit AdamW |
| 10GB | --blocks_to_swap 22・T5XXLはfp8形式を推奨 |
| 8GB | --blocks_to_swap 28・T5XXLはfp8形式を推奨 |
--blocks_to_swapはモデルの一部をCPUとGPUの間で入れ替えてVRAMを減らす実験的な機能で、数を増やすほどVRAMは減るが学習は遅くなる。SDXLは公式の文書に必要量の目安が無く、「24GBでも設定によってはメモリが足りなくなる」と書かれている。減らす手段として挙げられているのは、混合精度(bf16かfp16)・--gradient_checkpointing・VAEとテキストエンコーダーの出力のキャッシュ(--cache_latents・--cache_text_encoder_outputs)・--fused_backward_pass(SDXLで使える実験的な機能・Adafactorだけ対応・勾配の累積とは併用できない)だ。
📘 VRAMを減らす設定が速度をどう変えるかを数字で知りたい方へ:当サイト運営者がZennで公開している電子書籍『画像生成AI・ローカルLLMを“安く速く”動かす実測ガイド』(有料・500円/第1〜2章は無料公開)で、量子化・オフロード・スライスがVRAMと速度をどう変えるかを実機で実測しています(画像生成と推論の実測で、LoRAの学習は測っていません)。節約テクの多くはVRAMを時間で買う取引で、効く場面と効かない場面がはっきり分かれました。
設定を詰めても学習が遅い・待ち時間を減らしたいなら、GPUの選び方とクラウドの使い分けをLoRA学習を高速化する方法にまとめている。
高VRAMのGPUを用意できない場合は、クラウドでLoRA学習する方法もあります。ConoHa AI Canvasはスタンダードプラン(月額4,378円・税込)以上ならブラウザからKohya SSを使え、GPUを買わずにLoRA学習からテスト生成までこなせます(月額1,100円のエントリープランではLoRA学習は使えません)。
 ※ 高価なGPU不要・LoRA学習(Kohya SS)はスタンダードプラン以上=月額4,378円(税込・WebUI 50時間込み)
💡 毎月の課金より手元のGPUで回したいなら:上の表のとおり、FLUX.1は24GBなら基本の設定、16GB以下はブロックの入れ替えで速度と引き換えになる。GPUごとの構成と公式の価格はローカルAI画像生成のおすすめBTO PC構成、GPUの価格の推移はRTX 5070 Ti搭載PCの価格推移と買い時にまとめている。

Kohya_ssの学習手順と重要パラメータ
「10_name」フォルダ命名規則とステップ数の計算
sd-scriptsでは、学習用の画像フォルダの名前で繰り返し回数を指定できる(公式の文書の形は<繰り返し回数>_<identifier> <class>)。「10_chara」なら「1エポックの中でその画像を10回ずつ使う」という意味だ。データセットの設定ファイル(.toml)を使う場合は、num_repeatsで同じ指定ができる。
# 学習用の画像フォルダの名前(sd-scripts の文書の形)
<繰り返し回数>_<identifier> <class>

# 例: 1エポックの中でその画像を10回ずつ使う場合
10_chara girl

# .toml のデータセット設定で指定する場合
num_repeats = 10
総ステップ数 = (画像数 × 繰り返し回数 ÷ バッチサイズ) × エポック数
例:画像30枚・繰り返し10・バッチ1・10エポック → 3,000ステップ
何ステップが適正かは、データセットと学習率で変わるので決まった値は無い。sd-scriptsの公式の例は--max_train_epochs=10と--save_every_n_epochs=1(1エポックごとに保存)で、エポックごとのLoRAを同じプロンプトで生成して並べ、崩れる手前のものを選ぶのが確実だ。
推奨パラメータ設定
sd-scriptsの公式の文書にあるSDXLのLoRAの例はnetwork_dim 32・network_alpha 16・学習率 1e-4・10エポックだ。alphaはdimの半分くらいにするのが一般的と書かれており、テキストエンコーダーの学習率はU-Netより小さい値が推奨されている。ここから始めて、仕上がりを見ながら1つずつ変えるのが基本になる。
学習率の調整に迷うなら、学習率を自動で推定するProdigyオプティマイザという選択肢がある。公式のREADMEは学習率を1.0にすることを勧め、拡散モデルではsafeguard_warmup=True・use_bias_correction=True・weight_decay=0.01を勧めている。推定される学習率を大きく(小さく)したいときはd_coef(既定1.0)を変える。なお、sd-scriptsのLoRA+(loraplus_lr_ratio)は、LoRAの上向きの重みの学習率を下向きの何倍にするかの指定で(論文の推奨は16)、ProdigyやDAdaptationとは併用できない。
# SDXL の LoRA(sd-scripts の公式の文書の例・2026年10月5日に確認)
--network_dim=32
--network_alpha=16
--learning_rate=1e-4
--max_train_epochs=10
--save_every_n_epochs=1

# Prodigy を使う場合(Prodigy の公式 README の推奨)
--optimizer_type=Prodigy
--learning_rate=1.0
--optimizer_args "safeguard_warmup=True" "use_bias_correction=True" "weight_decay=0.01"Kohya_ssのパラメータ設定を体系的に学びたい場合は、Udemyの動画講座でハンズオン形式でも学べます。
DoRAとは?LoRAとの違い
DoRA(Weight-Decomposed Low-Rank Adaptation)は、元の重みを「大きさ」と「方向」に分け、方向の更新にLoRAを使う手法だ。論文は、全体の学習(フルファインチューニング)の学習能力に近づけることを狙い、推論の負担を増やさずにLoRAの学習能力と安定性を高めたとし、LLaMA・LLaVA・VL-BARTの調整でLoRAを上回ったと報告している。画像生成のキャラクターLoRAで再現性がどれだけ上がるかは、論文の評価の範囲外で、当サイトも測っていない。sd-scriptsでは、LyCORISを使って--network_module lycoris.kohyaと--network_args "algo=lora" "dora_wd=True"で有効にできる(LyCORISの文書)。
学習失敗のトラブルシューティング
ブリード現象(顔が他キャラに混入)
まず生成時のLoRAの強さ(ウェイト)を下げて様子を見るのが手軽だ。学習し直すなら、sd-scriptsの--network_dropout(LoRAの中のドロップアウト・公式の文書は過学習を抑えるのに効くことがあるとしている)を試し、キャプションに書く語を見直す。
白黒・茶色への変色(オーバートレーニング)
学習しすぎ(過学習)で色や形が崩れることがある。1エポックごとに保存し(--save_every_n_epochs=1)、同じプロンプトで並べて、崩れる手前のエポックを使おう。学習中にメモリが足りなくなる場合はCUDA OOMエラーの解決方法も参照。
2026年、キャラクターLoRAはどのベースモデルで学習する?
LoRAはベースモデルを決めた時点で、必要VRAMも学習ツールもライセンスも決まる。ここを先に選ばないと、集めたデータセットごと作り直しになる。2026年10月5日時点の各公式で確かめた選択肢を並べる。
| ベースモデル | 学習のVRAM(公式の記載) | 主な学習ツール | モデルのライセンス | 向いている場面 |
|---|---|---|---|---|
| SDXL | 目安の記載なし(24GBでも設定次第で不足) | sd-scripts | CreativeML Open RAIL++-M(商用利用可・利用の制限あり) | 情報量が多い。まず1本作って手順を覚えるならここ |
| FLUX.1 [dev] | 8GB〜(ブロックの入れ替え・fp8が前提)/24GBで基本の設定 | sd-scripts | 非商用(FLUX.1 [dev] Non-Commercial License) | 個人の制作・検証 |
| FLUX.2 [klein] 4B | 学習の目安の記載なし(推論は約13GBとモデルカード) | AI-Toolkit(klein-base 4B) | Apache 2.0 | 仕事で使う画像を出すならここ |
| FLUX.2 [klein] 9B / [dev] | 学習の目安の記載なし | AI-Toolkit(klein-base 9B/dev) | 非商用(FLUX Non-Commercial License) | 個人の制作・検証 |
⚠️ 一番はまるのは「学習できたのに仕事で使えない」パターン: FLUXの非商用ライセンス(FLUX.1 [dev]・FLUX.2 [klein] 9B・[dev])では、モデルとLoRAなどの派生物を使えるのは非商用の目的に限られ、事業や仕事に関わる使い方・報酬が生じる使い方は含まれない。生成した画像そのものは「商用を含むどんな目的にも使える」と条文にあるが、仕事として生成するなら、モデルの使い方が非商用の範囲を外れる=Black Forest Labsの商用ライセンスが要る。軽いklein 4BだけがApache 2.0だ。案件用のキャラクターLoRAを作るつもりなら、データセットを集める前にベースモデルとライセンスを決め、条文を自分で確かめておく(当サイトは法的な助言はしない)。
FLUX.2で学習するならツールが変わる
SDXLとFLUX.1はsd-scriptsで学習できるが、sd-scriptsの対応モデルにFLUX.2は無い(0.12.0・2026年9月24日)。FLUX.2系を学習するなら、AI-Toolkit(FLUX.2 [dev]・klein-base 4B・klein-base 9Bに対応・GUIとコマンドラインの両方で使える)が選択肢になる。学習には蒸留していないbase版(klein-base)を使う点にも注意したい。
逆に言えば、本記事のsd-scripts向けの設定(Prodigy・fused_backward_pass・blocks_to_swapなど)はSDXL/FLUX.1の話だ。FLUX.2へ移るときはツールごと乗り換える前提で読んでほしい。
結局どれを選ぶか
①はじめての1本=SDXL+sd-scripts(情報が多く、詰まっても答えが見つかる)/②個人の制作でFLUXを使いたい=FLUX.1 [dev]+sd-scripts(非商用)/③仕事で使う=FLUX.2 [klein] 4B(klein-base 4BをAI-Toolkitで学習・Apache 2.0)。③を選ぶ人が②を経由する必要はありません。
この記事の出典(すべて2026年10月5日に確認)
学習ツール:sd-scripts(README・対応モデルと0.12.0の変更履歴)/FLUX.1の学習の文書(VRAM別の設定)/SDXLの学習の文書(公式の例・fused_backward_pass)/発展的な設定(LoRA+・network_dropout・SDXLのVRAM)/学習の共通の文書(フォルダ名での繰り返し回数)/AI-Toolkit(README・対応モデル)
設定と手法:Prodigy(README)/DoRAの論文(arXiv 2402.09353)/LyCORIS(dora_wd)
ライセンス:SDXL(CreativeML Open RAIL++-M)/FLUX.1 [dev] Non-Commercial License(2.「Outputs」の条)/FLUX Non-Commercial License v2.1(FLUX.2 [dev]・klein 9B)/FLUX.2 [klein] 4B(Apache 2.0・約13GB)/FLUX.2 [klein] 4B Base(蒸留していないLoRA学習向けの版)/Black Forest Labsの商用ライセンス
まとめ:LoRA作りで迷わないための5つの手順
- ベースモデルとライセンスを先に決める(仕事で使うならFLUX.2 [klein] 4BかSDXL)
- データは枚数より、表情・角度・服装の偏りと画質を先に整える
- キャプションには後から変えたい要素(服など)を書く
- 学習ツールの公式の例(SDXLならdim 32・alpha 16・学習率 1e-4・10エポック)から始める
- 1エポックごとに保存し、並べて比べて崩れる手前を選ぶ
学習はVRAMと時間を使う。手元のGPUで回すならGPUごとの構成と公式の価格を、学習の待ち時間を減らしたいならLoRA学習を高速化する方法も参考にしてほしい。

コメント