LongCat-Image(6B)は、VRAM 16GB の RTX 4070 Ti SUPER で、公式の推奨設定(cfg 4.0・50ステップ)のまま動きました。1024×1024 の1枚目(モデルの読み込み込み)は76.3秒、生成中の VRAM の空きは最小0.62GiBでした。
ComfyUI には LongCat の公式サンプルが無いので、ワークフローは自分で組みます。ポイントは CFGNorm ノードと cfg 4.0。cfg 1.0・20ステップに下げると1枚目は34.2秒まで縮みましたが、絵は装飾だらけに崩れました。
LongCat-Image は、Meituan(美団)の LongCat チームが Apache-2.0 で公開している 6B の画像生成モデルです。ComfyUI は標準で対応しカスタムノードは不要ですが、公式のサンプルワークフローがありません。VRAM 16GB の検証機で組んだ手順と、かかった時間・VRAM をまとめました。
LongCat-Imageに必要なファイルは3つ(2つは他のモデルと共有)
| 種類 | ファイル | サイズ | 置き場所(models/ 以下) |
|---|---|---|---|
| 本体 | longcat_image_bf16.safetensors | 12.54GB | diffusion_models |
| テキストエンコーダ | qwen_2.5_vl_7b_fp8_scaled.safetensors | 9.38GB | text_encoders |
| VAE | ae.safetensors | 0.34GB | vae |
本体は Hugging Face の Comfy-Org/LongCat-Image、テキストエンコーダは Qwen-Image 用のもの(Comfy-Org/Qwen-Image_ComfyUI)、VAE は Flux 1 や Z-Image と同じです。ComfyUI 本体のコード(comfy/text_encoders/longcat_image.py)でも、Qwen2.5-VL 7B のエンコーダを使うことを確かめました。Qwen-Image と Z-Image を試したことがあれば、追加で落とすのは本体の12.54GBだけです。
ComfyUIでのワークフローの組み方(9ノード)
当サイトで動かしたのは次の9ノードです。cfg 4.0・50ステップは本家のモデルカードの推奨値、サンプラー・解像度・シードは当サイトが決めた値です。
| ノード | 設定 |
|---|---|
| UNETLoader | longcat_image_bf16.safetensors |
| CLIPLoader | qwen_2.5_vl_7b_fp8_scaled.safetensors/種類は longcat_image |
| VAELoader | ae.safetensors |
| CFGNorm | strength 1.0(UNETLoader と KSampler の間に入れる) |
| CLIPTextEncode ×2 | プロンプトとネガティブ |
| EmptySD3LatentImage | 1024×1024 |
| KSampler | 50ステップ・cfg 4.0・euler/simple |
| VAEDecode → SaveImage | — |
CFGNorm は、本家の推論コード(diffusers)の enable_cfg_renorm=True に当たる処理として入れました。どちらも「cfg をかけた後の予測の大きさを、プロンプトありの予測の大きさを超えないように縮める」処理です(両方のコードを読んで確認・細部の計算は同一ではありません)。ComfyUI では実験的なノードで、「advanced → guidance」の下にあります。
本家の推論コードにある「プロンプトの書き換え(enable_prompt_rewrite)」に当たる処理は入れていません。
結果:推奨設定で76.3秒、VRAMの空きは0.62GiB
| 指標 | 実測 |
|---|---|
| 結果 | 成功(ジョブの状態は success・1024×1024 の画像が保存された) |
| 1枚目の所要時間(モデル未読み込みから) | 76.3秒 |
| 測定開始時点の空き | 14.66GiB(総容量 15.99GiB) |
| 生成中の空きの最小値 | 0.62GiB |
| 生成で増えた使用量(開始時の空き − 最小値) | 約14.05GiB |
環境:RTX 4070 Ti SUPER(VRAM 16GB)・ComfyUI 0.20.1(デスクトップ版)・Windows 11。VRAM の空きは、ComfyUI が報告する GPU の空き容量を0.25秒ごとに299回読み取った値の最小です。所要時間は、ComfyUI の API に投げてから完了を確認するまで(1秒刻みで確認)。2026年9月9日測定。その後デスクトップ版は 0.21.1 に更新されていますが、この版では測り直していません。
本体とエンコーダのファイルを合わせると約21.9GBで、VRAM の総容量より大きいのですが、最後まで回りました(ComfyUI がどの順に載せ替えたかは確かめていません)。ただし空きは0.62GiBまで減っています。16GBで動くが、余裕はほとんど無いという読み方になります。ブラウザなど GPU を使うものは閉じてから回すのが無難です。
 ※ 月額1,100円〜(WebUIの無料時間つき・超過分は時間課金)・ComfyUI・AUTOMATIC1111対応・公式の対応モデルはStable Diffusion 1.5/2.0/2.1/XL(この記事のLongCat-Imageは対応一覧に無い)
cfg 1.0・20ステップに下げると速いが、絵が崩れる
他のモデルと揃えた比較用の設定(cfg 1.0・20ステップ)でも回しました。プロンプト・シード・解像度は同じで、変えたのはステップ数と cfg の2つです。
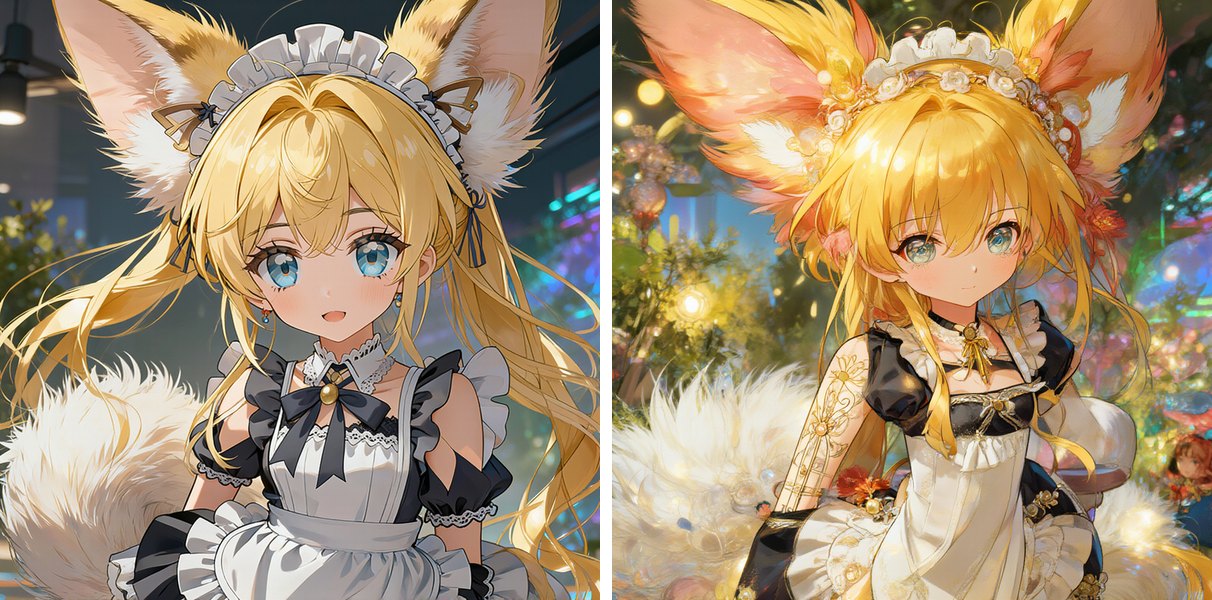
| 設定 | 1枚目(読み込み込み) | 2枚目(読み込み済み) | 1ステップ | 絵 |
|---|---|---|---|---|
| cfg 4.0・50ステップ(推奨) | 76.3秒 | — | — | プロンプトどおり |
| cfg 1.0・20ステップ | 34.2秒 | 11.0秒 | 0.55秒 | 装飾過多で背景が騒がしい |
1ステップは、読み込み済みの2枚目の所要時間を20で割った値です。推奨設定の2枚目は測っていません。
この1枚では、cfg 1.0・20ステップの絵は耳が羽根のような形になり、背景に光の玉や花が散らばり、右下には指示していない別の人物まで入りました。推奨設定のほうは、指示した要素(キツネの耳・金髪・青い目・メイド服・尻尾)がそのまま出ています。ステップ数と cfg を同時に変えたので、どちらが原因かは切り分けていません。各1枚の目視で、画質を数値で比べたものでもありません。
同じ条件での1ステップは、同じ 6B の Z-Image Turbo(0.80秒)より LongCat(0.55秒)が短い値でした。ただしこの設定では LongCat の絵が崩れるので、「LongCat のほうが速い」とは言えません(Z-Image はZ-Image Turbo を VRAM 16GB で測った記事)。
fp16中間値のオプションは差が見えなかった
起動オプション --fp16-intermediates を付けても、上と同じ cfg 1.0・20ステップの条件で1ステップは0.55秒のまま、生成で増えた使用量も14.28GiBから14.32GiBでした。同じシードの絵もほぼ同じです(元の画像との差は PSNR 47.50dB)。各1回の比較なので効果が無いとまでは言えませんが、付ける理由は見つかりませんでした。VRAM があふれたときの時間の損はComfyUI の VRAM 不足のコストを測った記事で扱っています。
まとめ
LongCat-Image は VRAM 16GB でも本家の推奨設定のまま動きました。CLIPLoader の種類を longcat_image にし、CFGNorm を挟んで cfg 4.0・50ステップ。cfg とステップを下げると絵が崩れたので、まずは推奨設定で回すのが確実です。ComfyUI の基本はComfyUI の使い方完全入門、モデルごとの VRAM の目安はAI画像生成のGPUとVRAMの選び方にまとめています。


コメント