測った範囲:RTX 4070 Ti SUPER(VRAM 16GB)1台・ComfyUI 0.20.1・プロンプト1つ・各条件1回ずつ(2026年9月28日)です。画質の優劣は付けていません。
結論:VRAM 16GBで、Z-Image Turbo・LongCat-Image・Qwen-Image 2512(GGUF Q4_K_M)・FLUX.2 [klein] 4Bの4本はすべて1024×1024で動きました。各モデルの推奨設定のまま2回目の生成にかかった時間は、klein 3.0秒・Z-Image 8.0秒・LongCat 53.1秒・Qwen-Image 113.3秒(Qwenは1328×1328)でした。同じ条件(20ステップ・CFGなし・1024²)にそろえても、1ステップあたりはkleinが最も短い0.50秒でした。

2026年後半はローカルで動く画像生成モデルが増え、「16GBのGPUでどれが実用的に動くのか」が選ぶときの分かれ目です。当サイトの検証機で、話題の4本を同じ日に同じ手順で測りました。
検証した環境とモデルは?
GPUはRTX 4070 Ti SUPER(16GB)で、起動直後の空きVRAMは14.73GiBでした。
| モデル | パラメータ | 使った重み |
|---|---|---|
| Z-Image Turbo | 6B | bf16(12.31GB) |
| LongCat-Image | 6B | bf16(12.54GB) |
| Qwen-Image 2512 | 20B | GGUF Q4_K_M(13.24GB) |
| FLUX.2 [klein] 4B(蒸留版) | 4B | bf16(7.75GB) |
ソフトはComfyUI 0.20.1のデスクトップ版です。kleinの公式が指定するテキストエンコーダ(qwen_3_4b)は、Z-Image用に置いていたファイルと配布元のsha256が同じだったので、同じファイルをそのまま使いました。追加で落としたのは本体とVAEだけです(どちらも配布元のsha256と照合)。
推奨設定で使うと、待ち時間はどれくらい?
モデルの読み込みが済んだ2回目で、klein 3.0秒からQwen-Image 113.3秒まで約38倍の開きがありました。
| モデル | 推奨設定 | 1回目(読み込み込み) | 2回目 |
|---|---|---|---|
| FLUX.2 klein 4B | 4ステップ・CFG 1・1024² | 19.0秒 | 3.0秒 |
| Z-Image Turbo | 9ステップ・CFG 1・1024² | 24.3秒 | 8.0秒 |
| LongCat-Image | 50ステップ・CFG 4・1024² | 75.1秒 | 53.1秒 |
| Qwen-Image 2512 Q4_K_M | 20ステップ・CFG 2.5・1328² | 136.3秒 | 113.3秒 |
時間はComfyUIのAPIに生成を投げてから完了するまでで、1回目はモデルを外した状態から、2回目はシードを1つ変えて(同じ条件だと結果の使い回しで生成されないため)測りました。推奨設定は、kleinがComfyUI公式テンプレート、ほかの3本は公式サンプルのワークフローの値です。この表の差は、モデルの速さよりも推奨されるステップ数・CFG・解像度の違いで生まれています。kleinとZ-Imageは少ないステップで仕上げる蒸留モデルで、Qwen-Imageは画素数が1024²の約1.68倍です。
同じ条件にそろえると、どれが速い?
20ステップ・CFG 1.0・1024²にそろえると、1ステップあたりはklein 0.50秒・LongCat 0.55秒・Z-Image 0.80秒・Qwen-Image 2.10秒でした。
| モデル | 1ステップあたり | 1回目だけの処理(1回目−2回目) |
|---|---|---|
| FLUX.2 klein 4B | 0.50秒 | 17.1秒 |
| LongCat-Image | 0.55秒 | 25.1秒 |
| Z-Image Turbo | 0.80秒 | 21.5秒 |
| Qwen-Image 2512 Q4_K_M | 2.10秒 | 26.1秒 |
1ステップあたりは2回目の所要時間を20で割った値で、画像の復元(VAE)と保存も含みます(同じ文章の読み取りは、ComfyUIが1回目の結果を使い回します)。右の列は1回目と2回目の差で、モデルの読み込みなど1回目にだけ起きる処理が入っていると考えられます(内訳は分けて測っていません)。そろえたのは設定であって、モデルごとの1ステップの計算量は同じではありません。CFGを1.0にそろえたのは、CFGが1より大きいとネガティブ側の計算が増えて1ステップの重さが変わるためです。サンプラー(euler)とスケジューラー(simple)もそろえたので、kleinの本来のスケジューラーとは違い、この設定の絵はkleinの本来の出来ではありません。
パラメータ数が同じ6BでもLongCatはZ-Imageより速く、4Bのkleinとほぼ同じでした。速さはパラメータ数だけでは決まりません。
VRAM 16GBに収まった?使用量は見分けられる?
4本ともメモリ不足で止まることはありませんでした。ただしVRAMの使用量からモデルの大きさは読み取れません。
生成中に0.25秒ごとにComfyUIが報告する空きVRAMを読み、開始時の空きから最も減った量を取りました(他のアプリは止めていません)。読み込み込みの1回目では12.93〜14.28GiBで、4本とも起動直後の空き(14.73GiB)をほぼ使い切りました。ComfyUIは空きに合わせてモデルを載せたり外したりするので、7.75GBのkleinでも14.15GiBを使いました。16GBに載るかどうかは、この数字ではなく完走したかどうかで判断しています。20Bの量子化でどこまで載るかはVRAM不足の遅さを測った記事で詳しく扱っています。
 ※ エントリー月額1,100円(WebUI無料時間10時間・超過は6.6円/分)/ComfyUI・AUTOMATIC1111から選べる・仕様の対応モデルの表はStable Diffusion 1.5/2.0/2.1/XL・プリインストールの一覧にZ-Image TurboとFLUX.2 [klein] 4Bはあり、LongCat-Image・Qwen-Imageは無い(2026年10月11日の公式)
画像はどう違う?
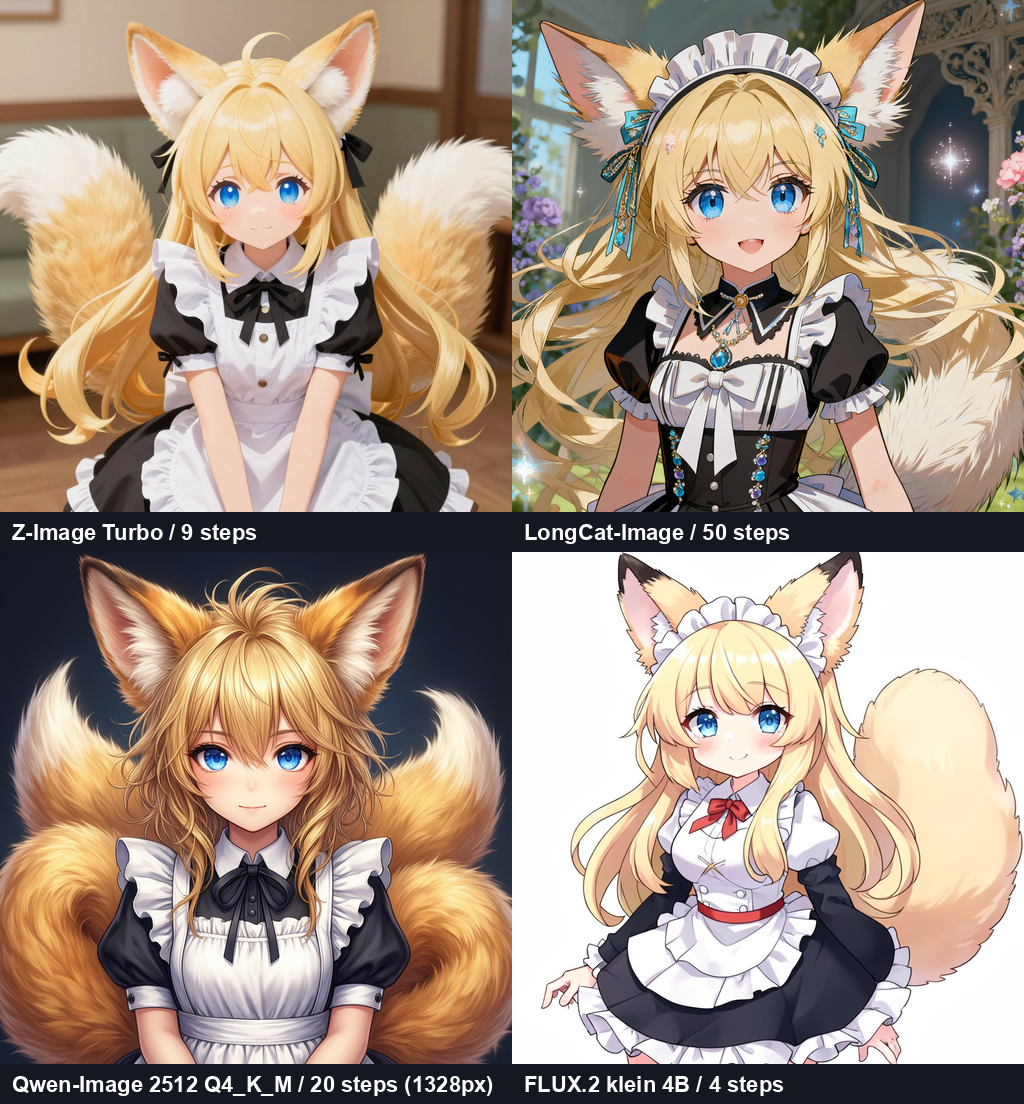
同じプロンプト・同じシードで、4本とも指示した要素(フェネック〈キツネ〉の耳・尻尾・金髪・青い目・メイド服)をそろえて描きました。
下は推奨設定の2回目に出た画像です(左上からZ-Image、LongCat、Qwen-Image、klein)。プロンプトは「a big fluffy tail」と尻尾を1本で指定しましたが、Z-ImageとQwen-Imageは尻尾が複数に見える描き方でした。1枚ずつの比較なので、ここから優劣は言えません。
3週間たっても同じ結果になる?
同じ手順で測り直すと、9月9日に測った3本の1ステップあたりの時間は±1%以内で一致しました。
Z-Image・LongCat・Qwen-Imageは9月9日にも同じ手順で測っており、今回の値はZ-Image ±0%・LongCat −0.9%・Qwen-Image ±0%でした。同じシードで出した画像も、19日前の画像とファイルのハッシュ(md5)まで一致し、画像を読み込んで比べても違う画素は0でした(3本×2回の6組。別の設定で出した画像と比べると約92万画素が違う)。どちらも各条件1回ずつの比較で、今回の条件ではこうだった、という範囲の結果です。
まとめ:16GBでどのモデルを使う?
待ち時間を短くしたいなら、推奨設定で3.0秒のklein 4Bか8.0秒のZ-Imageが向きます。LongCatとQwen-Imageは1枚に1〜2分かかるので、枚数を回すより1枚を作り込む使い方になります。どのモデルも16GBで完走したので、GPUを選ぶときは速さとモデルの種類で考えるのが現実的です。同じ16GBのRTX 5070 Tiを積んだ構成は3DCG・ローカルAI向けBTOの選び方で比べています。個別の設定は、Z-Image Turbo・LongCat-Image・FLUX.2の記事にまとめています。

コメント